


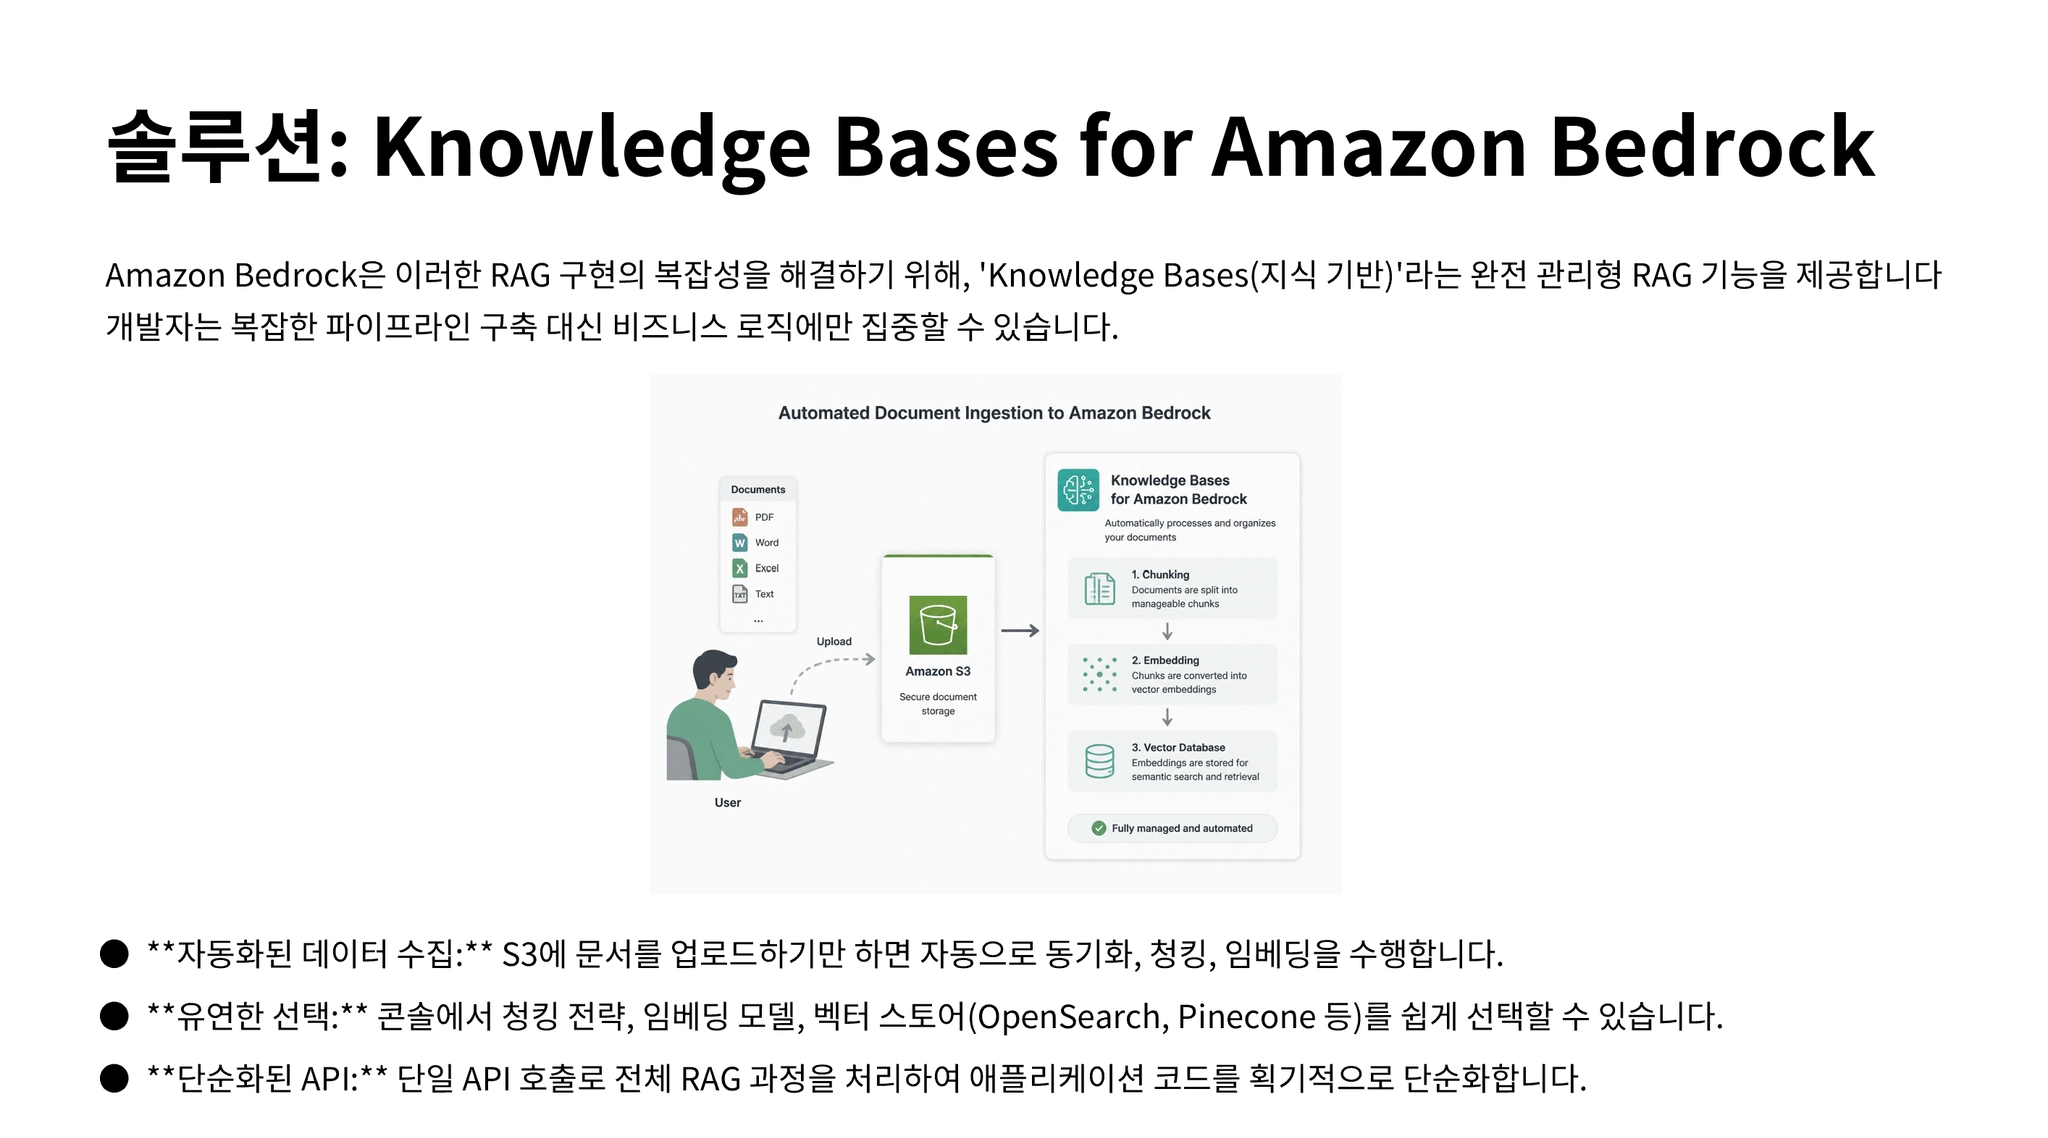
 AWS의 관리형 지식 기반은 데이터 수집, 스토리지 최적화, 고급 검색을 처리하므로 벡터 DB·데이터 파이프라인·검색 인프라를 직접 관리할 필요가 없습니다. S3, SharePoint, Confluence, Google Drive, OneDrive, 웹 크롤러 6개 기본 커넥터와 자동 동기화를 제공합니다.
검색증강생성
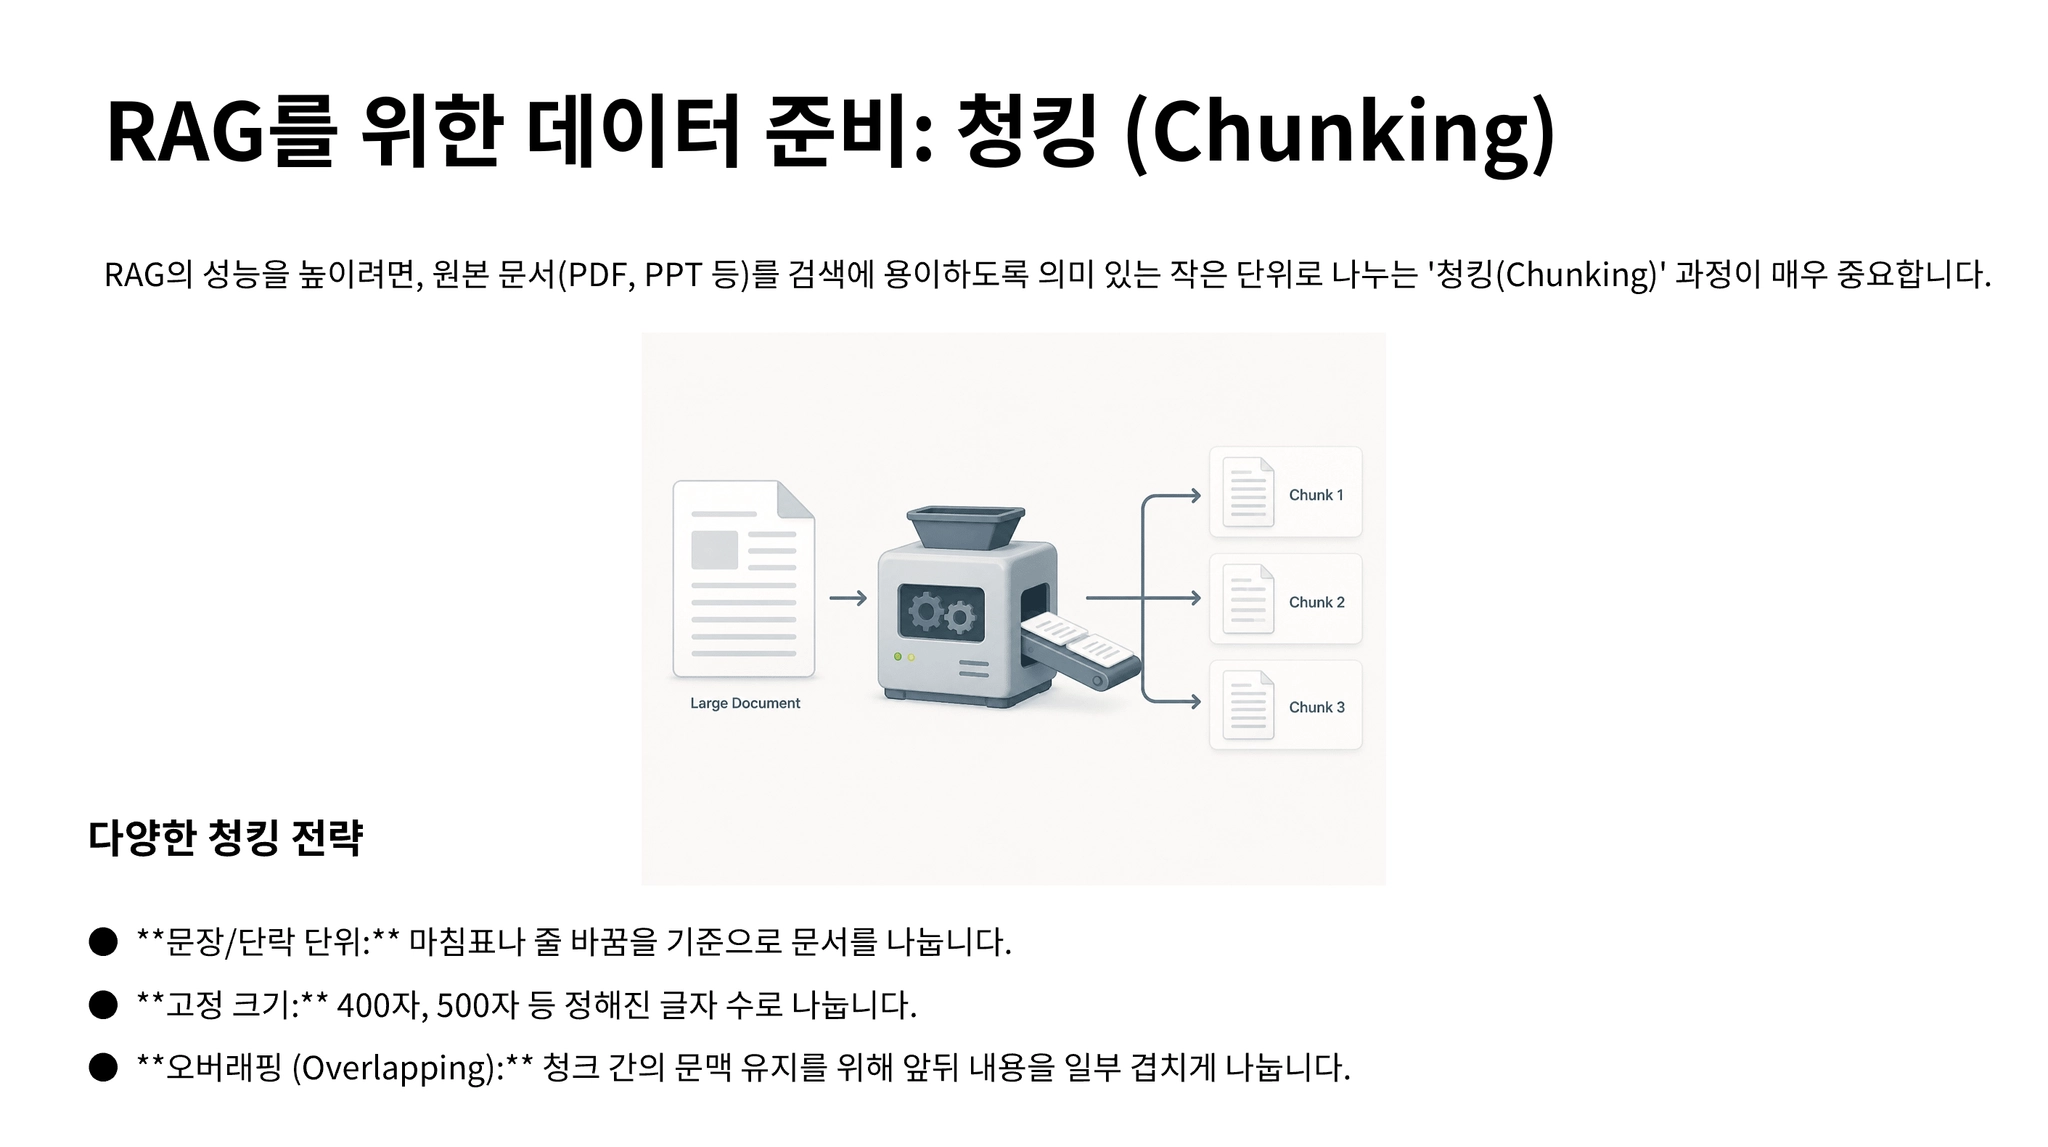
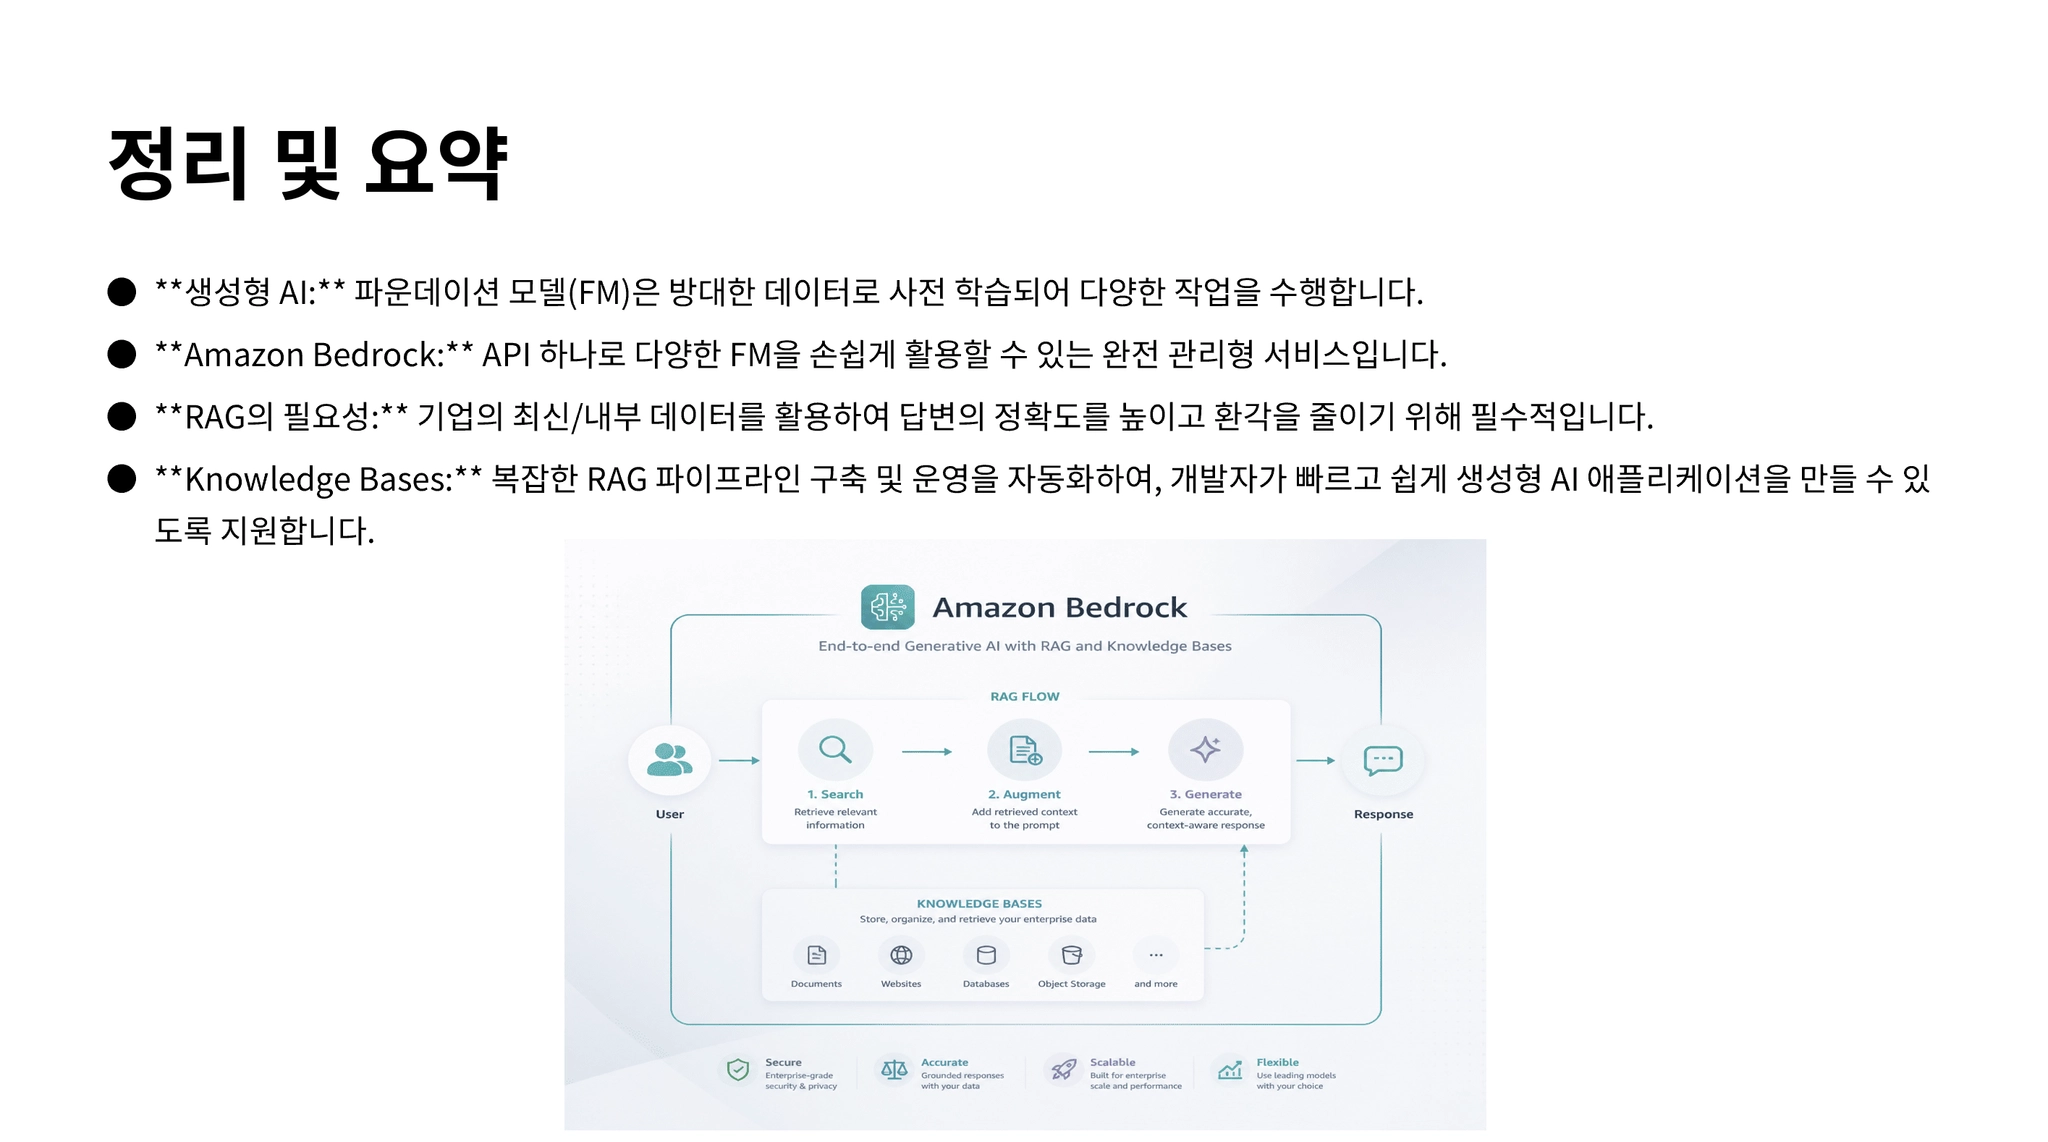
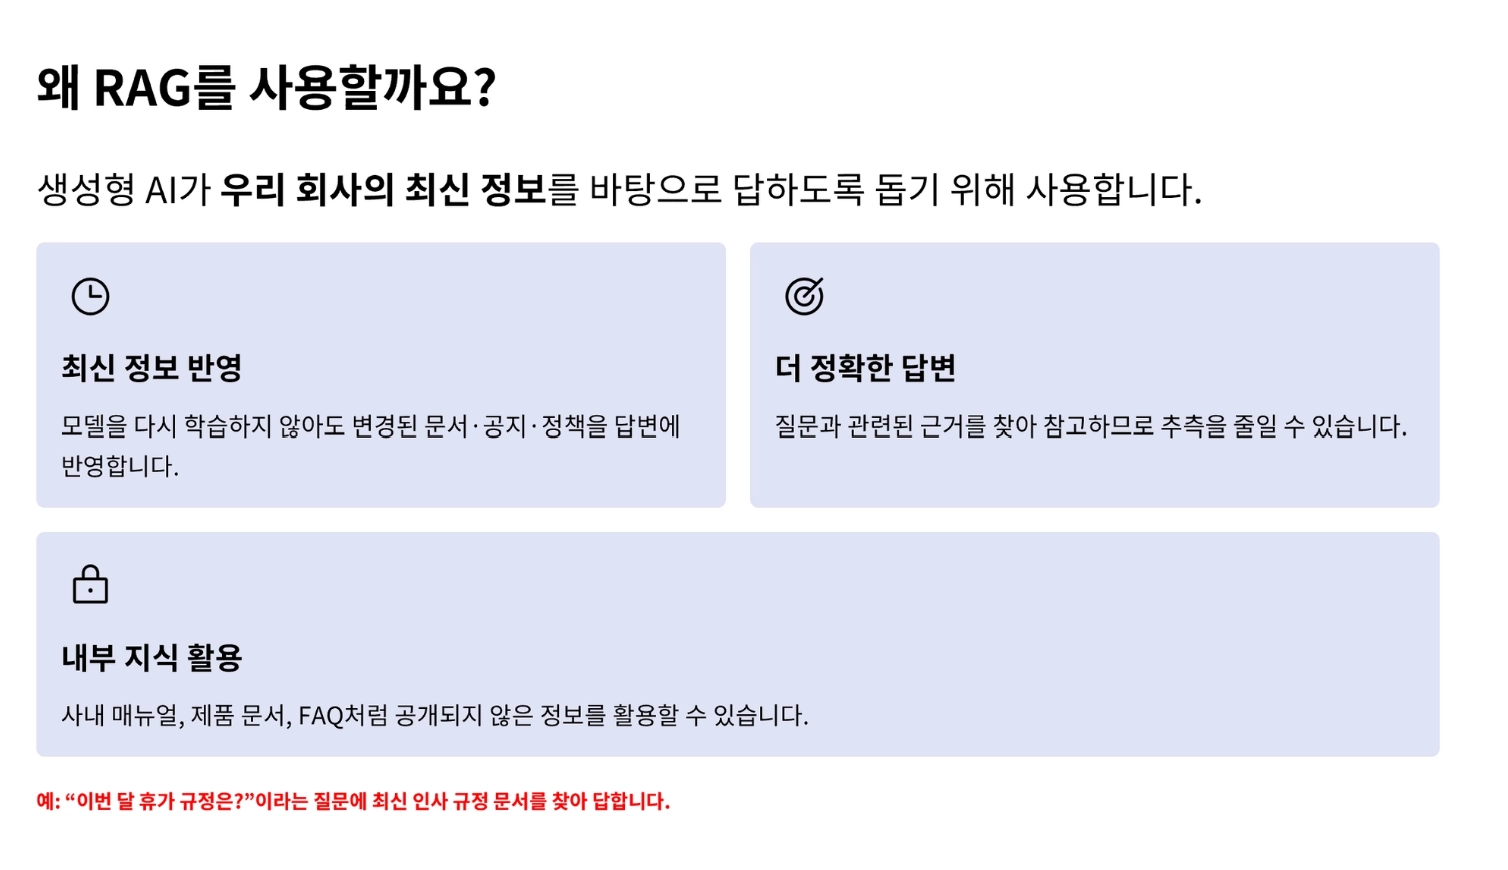
검색 증강 생성(Retrieval-augmented generation, RAG)은 대형 언어 모델 (LLM)이 새로운 정보를 검색하고 통합할 수 있도록 하는 기술이다. RAG를 사용하면 LLM은 지정된 문서 집합을 참조할 때까지 사용자 쿼리에 응답하지 않는다. 이 문서들은 LLM의 기존 훈련 데이터의 정보를 보완한다. 이를 통해 LLM은 훈련 데이터에서 사용할 수 없는 도메인 특정 및 업데이트된 정보를 사용할 수 있다. 예를 들어, 이는 LLM 기반 챗봇이 내부 회사 데이터에 접근하거나 권위 있는 출처를 기반으로 응답을 생성하는 데 도움이 된다. RAG는 응답을 생성하기 전에 정보 검색을 통합하여 대형 언어 모델 (LLM)을 개선한다.정적 훈련 데이터에 의존하는 기존 LLM과 달리 RAG는 데이터베이스, 업로드된 문서 또는 웹 소스에서 관련 텍스트를 가져온다.르스 테크니카에 따르면 "RAG는 LLM 프로세스를 웹 검색 또는 기타 문서 조회 프로세스와 혼합하여 LLM이 사실에 충실하도록 돕는 방식으로 LLM 성능을 향상시키는 방법이다." 이 방법은 환각 (인공지능)을 줄이는 데 도움이 되며, 챗봇이 존재하지 않는 정책을 설명하거나 변호사에게 주장을 뒷받침할 인용문을 찾도록 존재하지 않는 법적 사례를 추천하는 등의 원인이 되었다. RAG는 또한 새로운 데이터로 LLM을 재훈련할 필요성을 줄여 계산 및 재정 비용을 절감한다. 효율성 향상 외에도 RAG는 LLM이 응답에 출처를 포함할 수 있도록 하여 사용자가 인용된 출처를 확인할 수 있도록 한다. 이는 사용자가 검색된 콘텐츠를 교차 확인하여 정확성과 관련성을 확인할 수 있으므로 투명성이 향상된다. RAG라는 용어는 2020년 메타의 연구 논문에서 처음 소개되었다.
검색 증강 생성(RAG)
에이전트는 회사의 데이터 소스에 안전하게 연결하고 정확한 응답을 생성하기 위해 올바른 정보로 사용자 요청을 보강합니다. 예를 들어, 사용자가 청구 자격에 대해 질문하면 RAG 에이전트는 지식 베이스에서 정보를 조회하고 제출된 청구와 자격 정책 응답 간을 조정합니다.
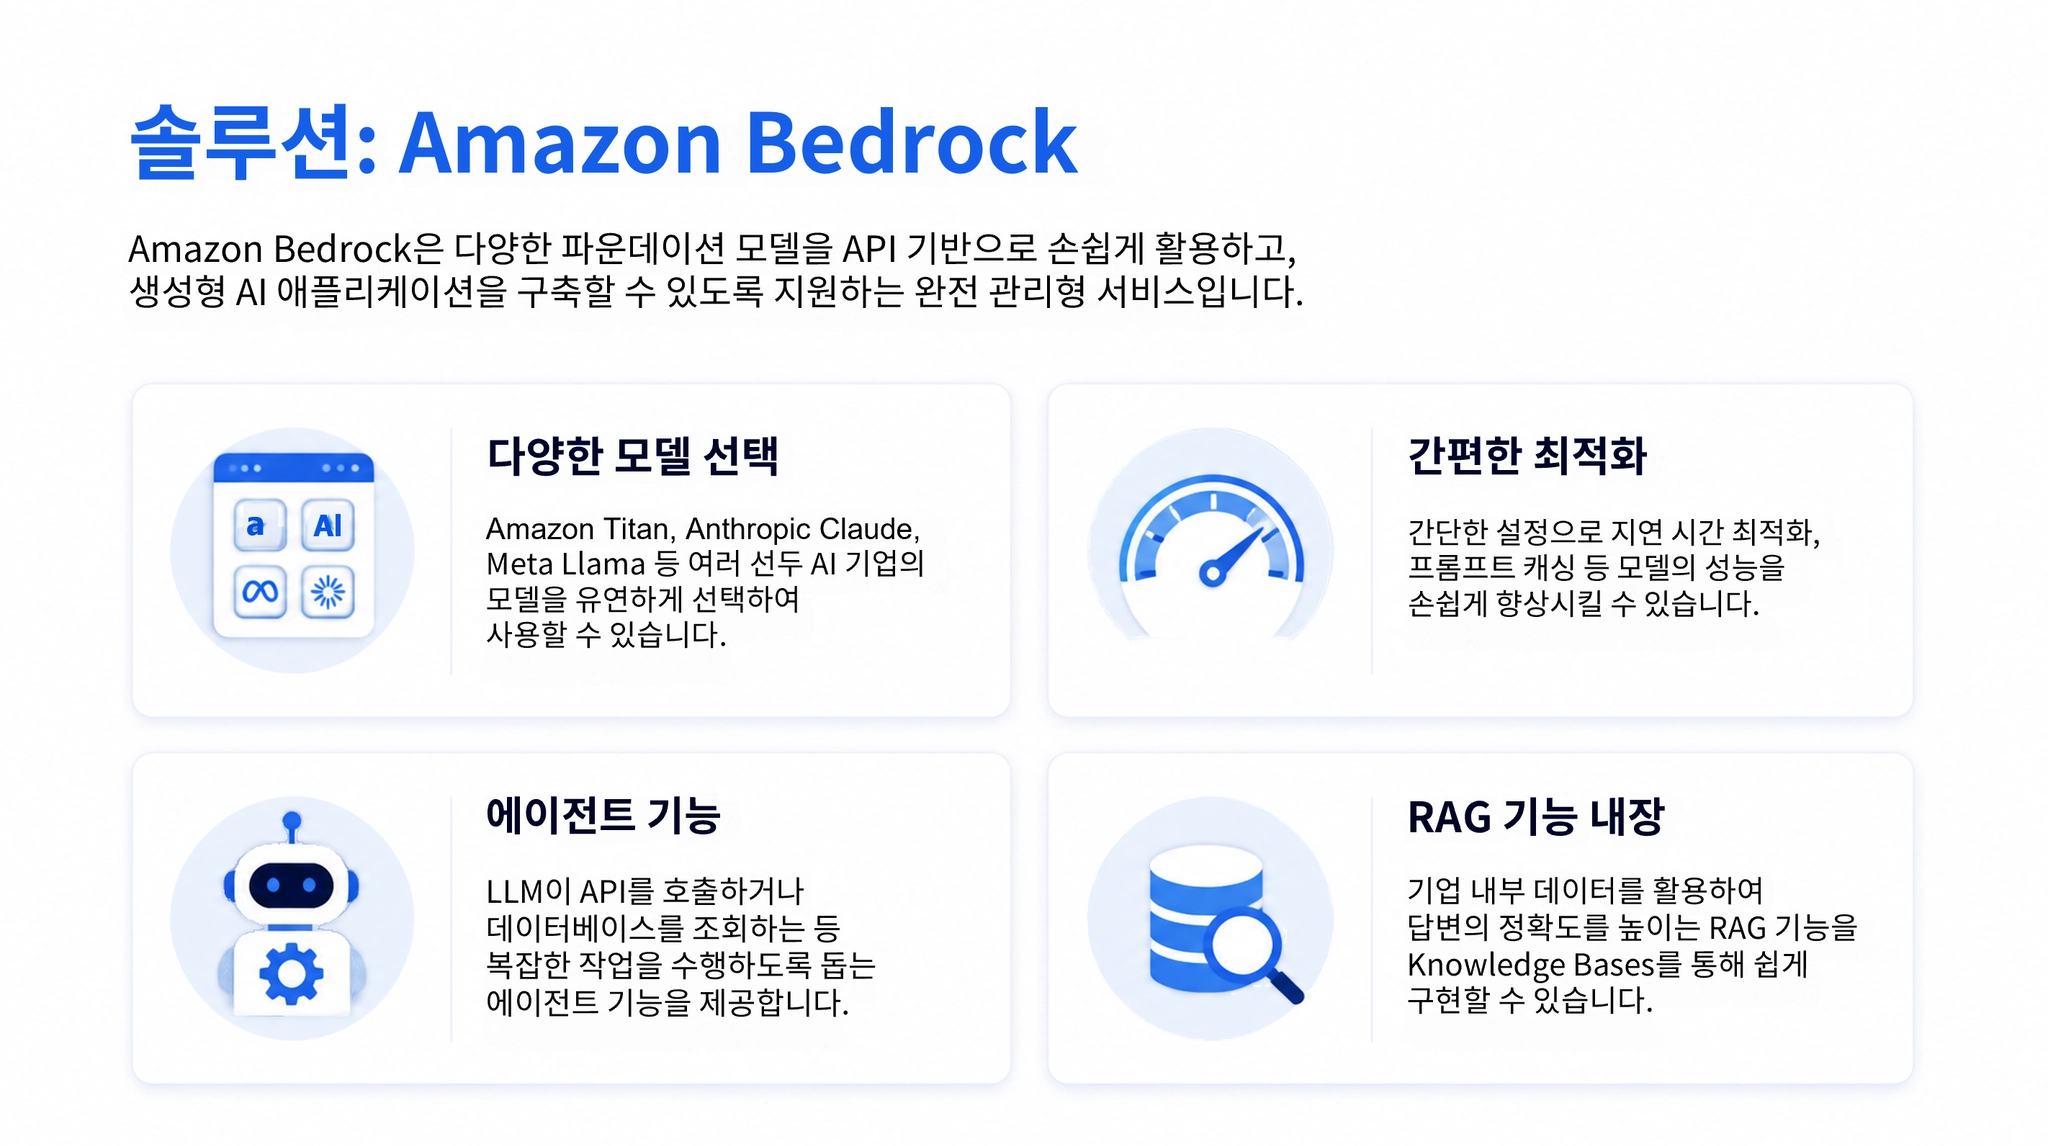
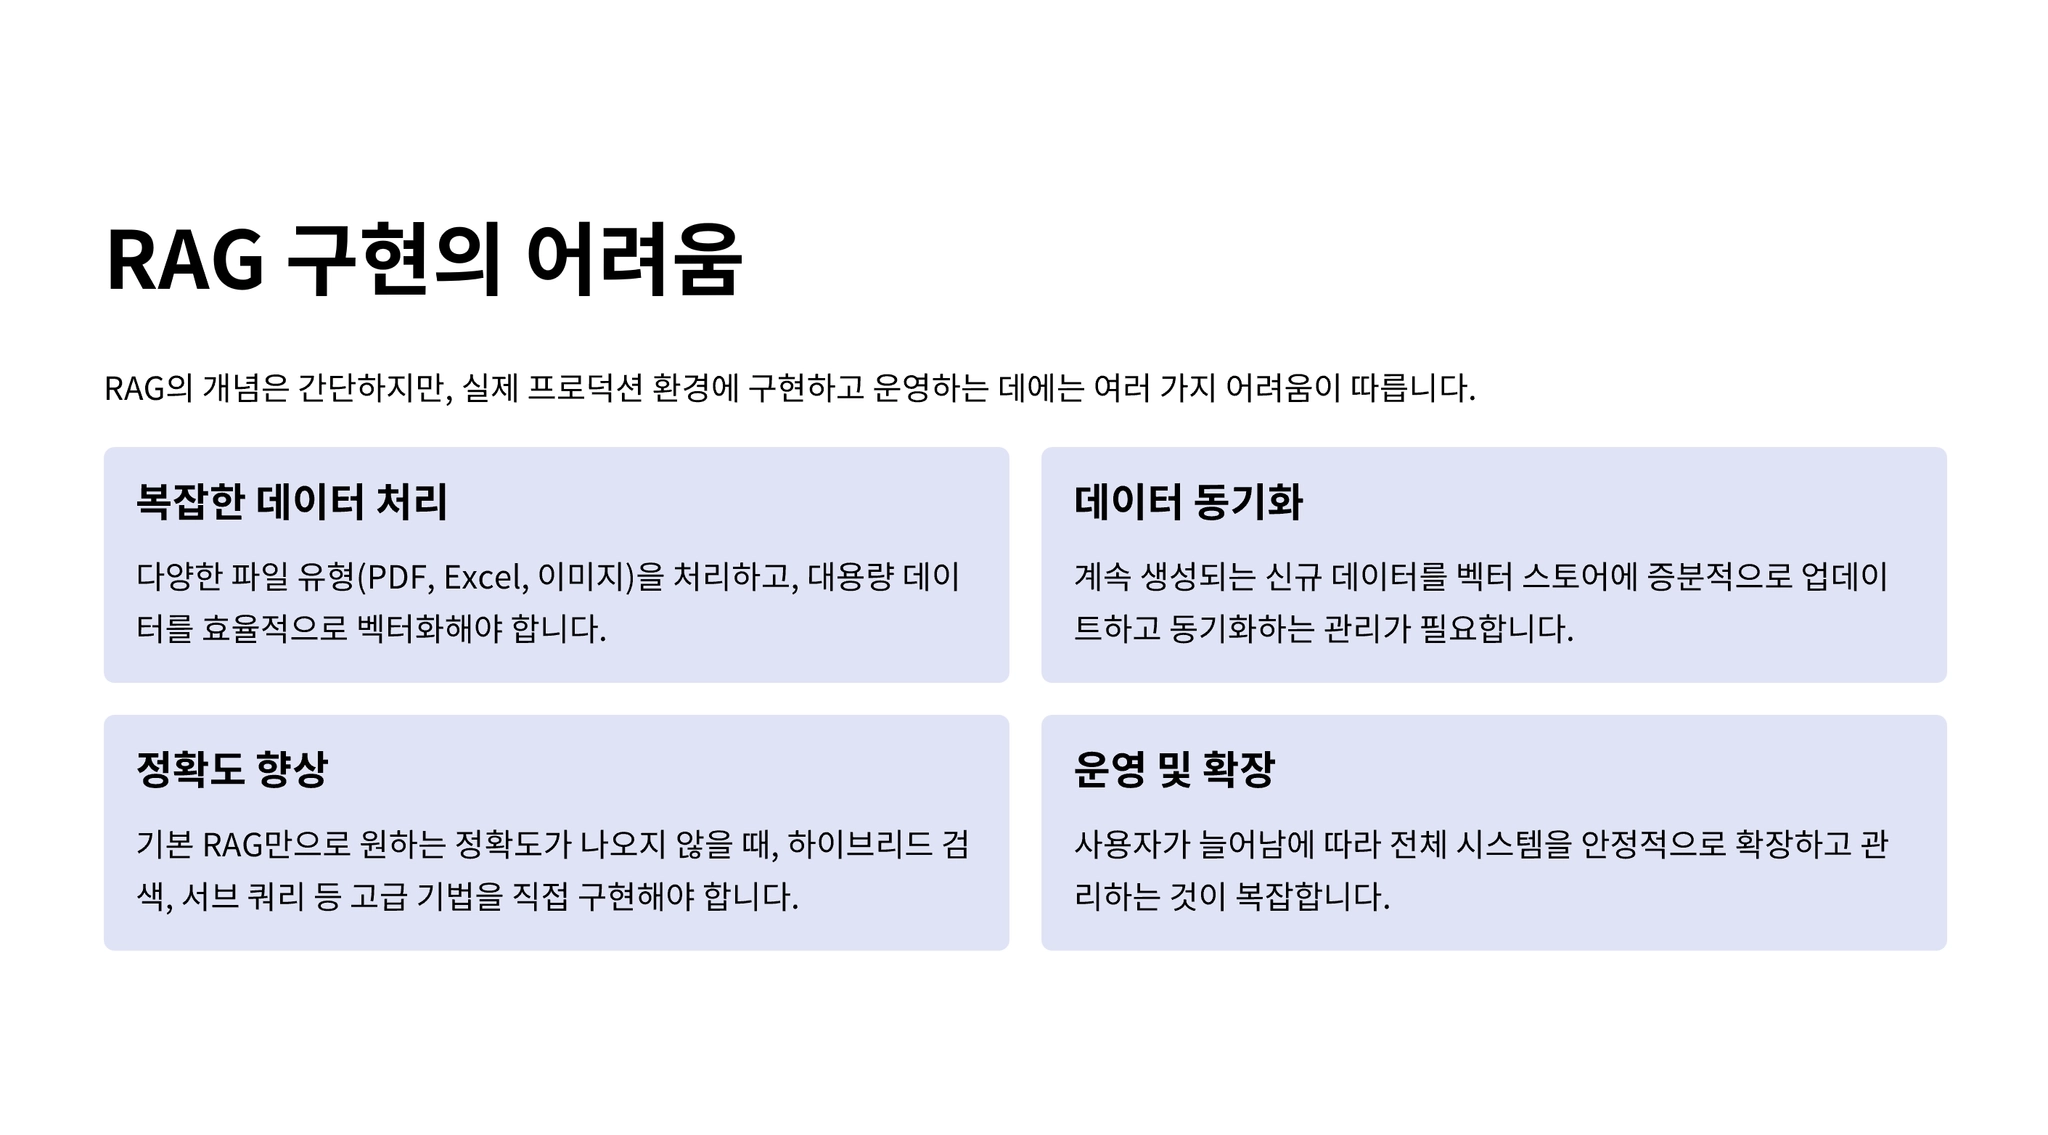
Amazon Bedrock Knowledge Bases는 고객의 자체 데이터 소스에서 컨텍스트 정보를 통합하여 고정확도, 저지연, 보안, 맞춤형 생성형 AI 애플리케이션을 생성할 수 있는 엔드투엔드 관리형 RAG 워크플로를 제공합니다.
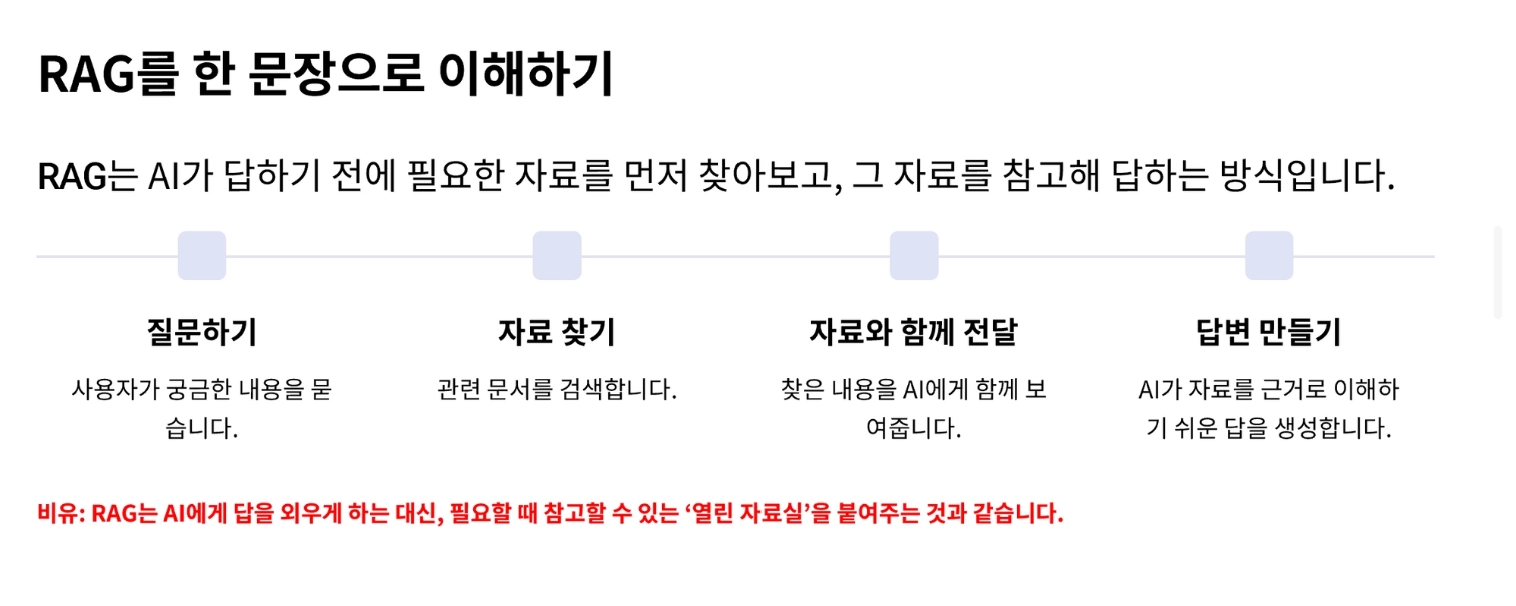
RAG 개요 (다시한번 정리하자료……)
•
RAG정의
◦
Retrieval-Augmented Generation(검색-증강-생성)
◦
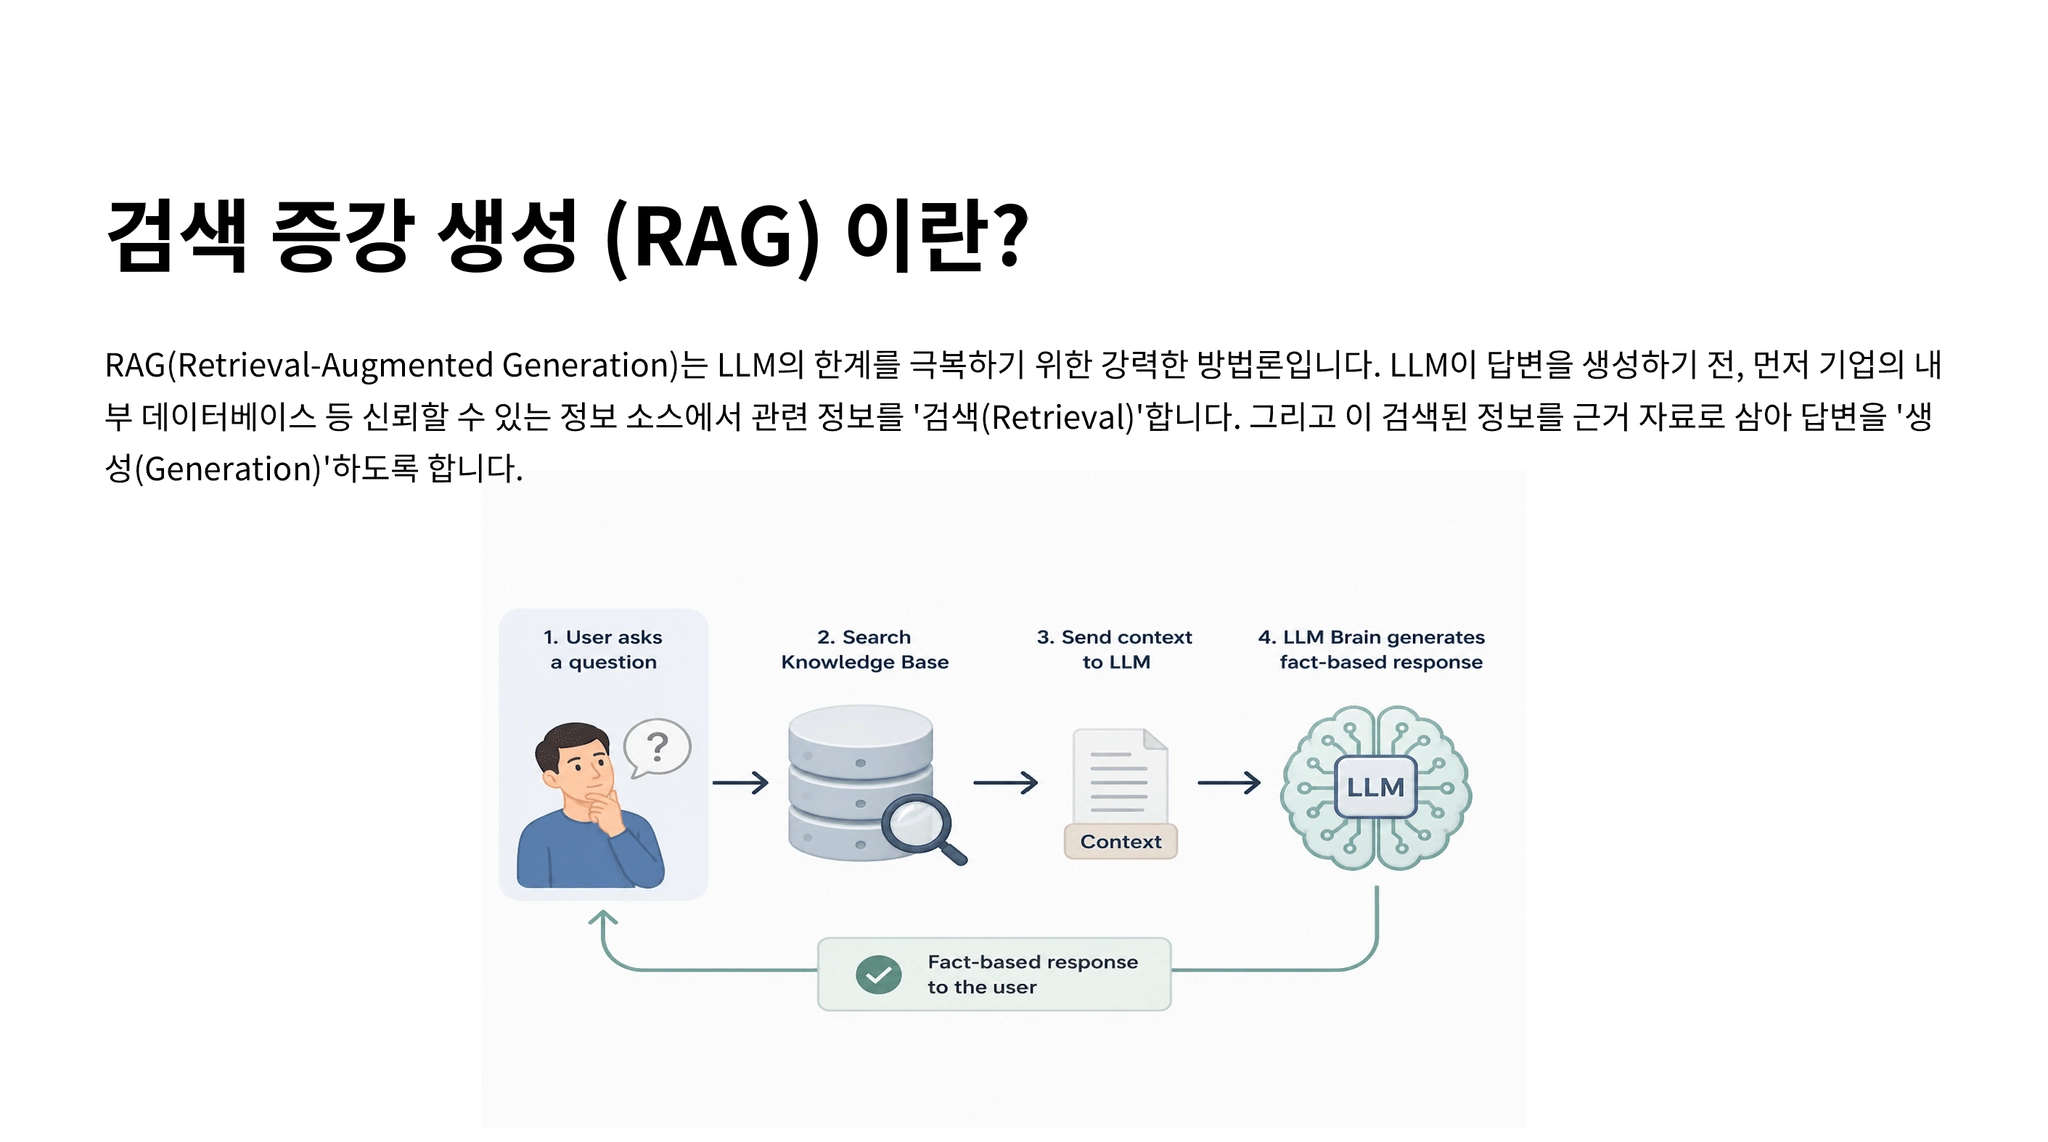
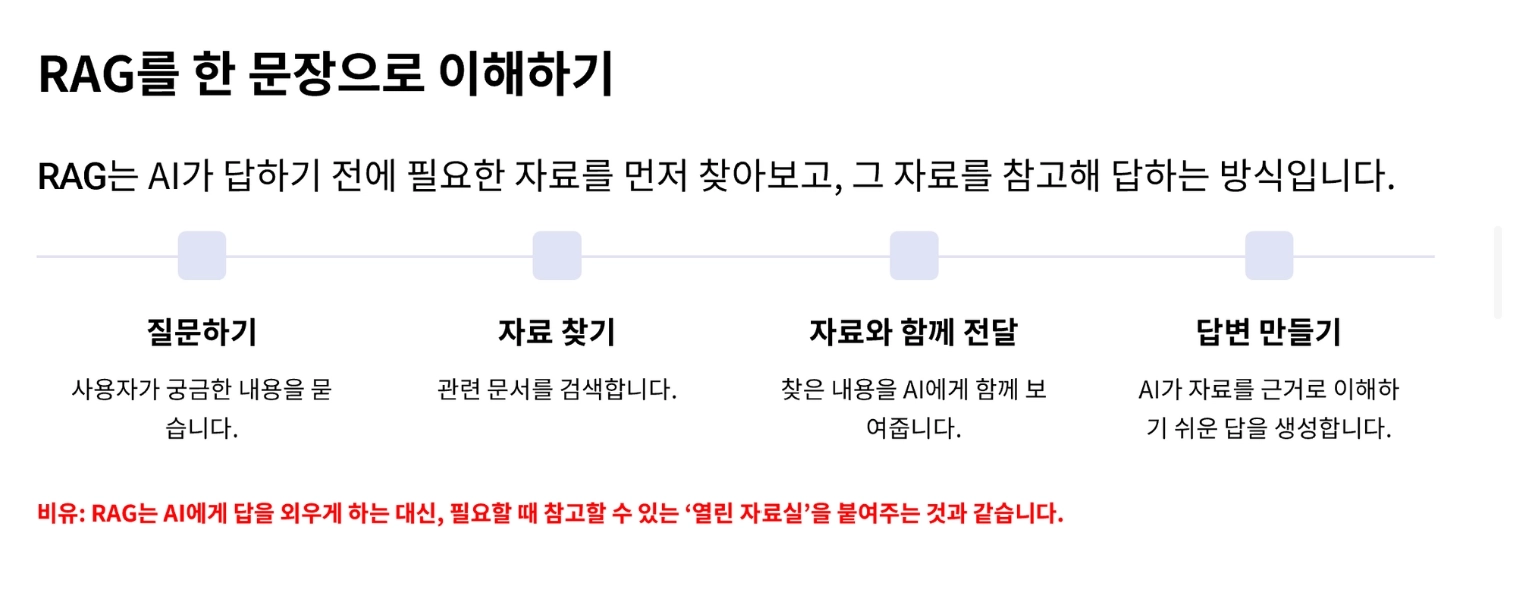
LLM이 답변을 만들기 전에 외부 지식(문서/DB/웹/사내 위키 등)에서 관련 내용을 찾아(검색) 근거 컨텍스트로 더 정확하고 최신의 답을 생성하게 하는 패턴
•
RAG의 사용이유
◦
사용자의 자연어 질의와 유사한 답변을 찾기 위함(RDB사용불가)
◦
LLM은 사내정책/사내문서 등의 정보를 정확히 알고 있지 못함(환각 감소)
◦
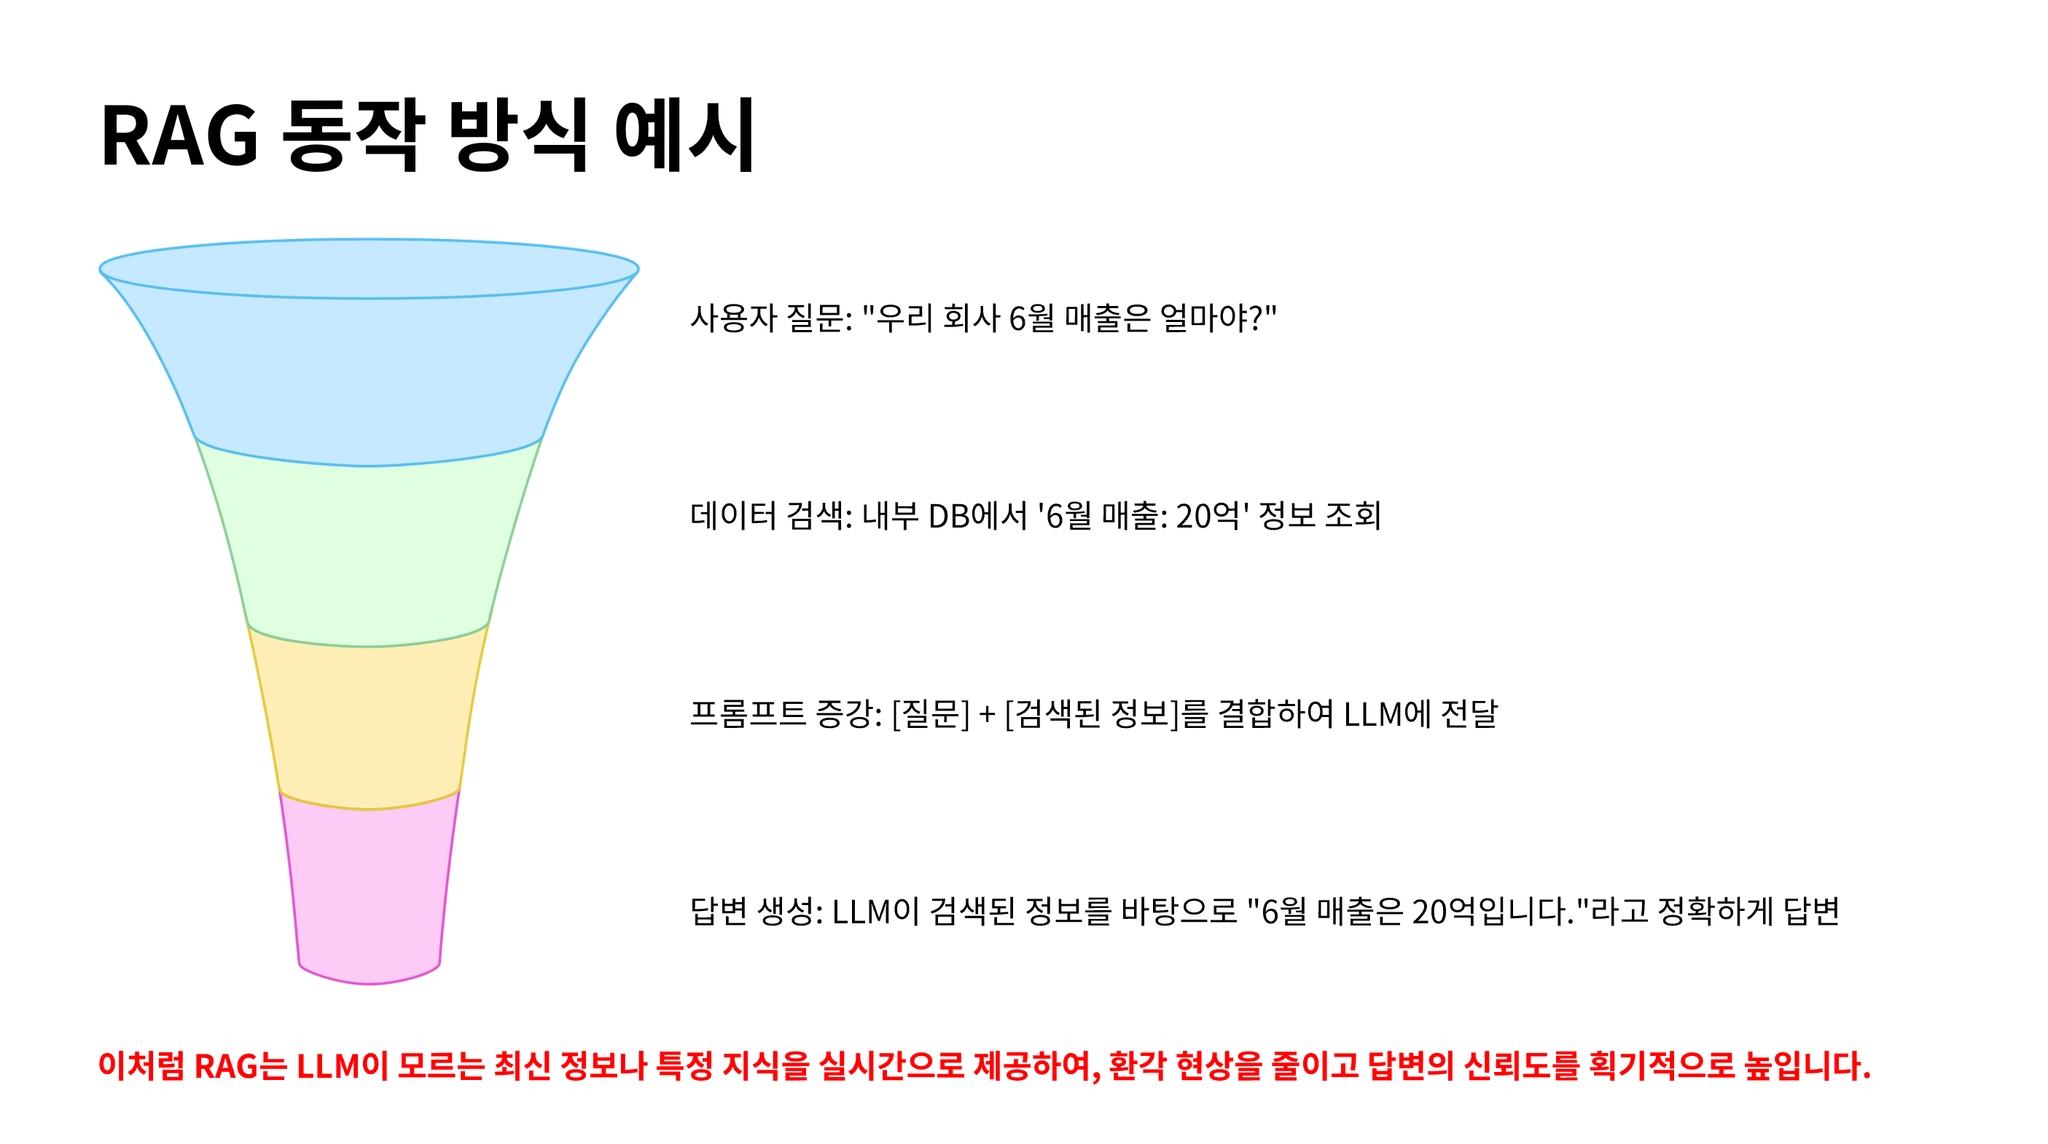
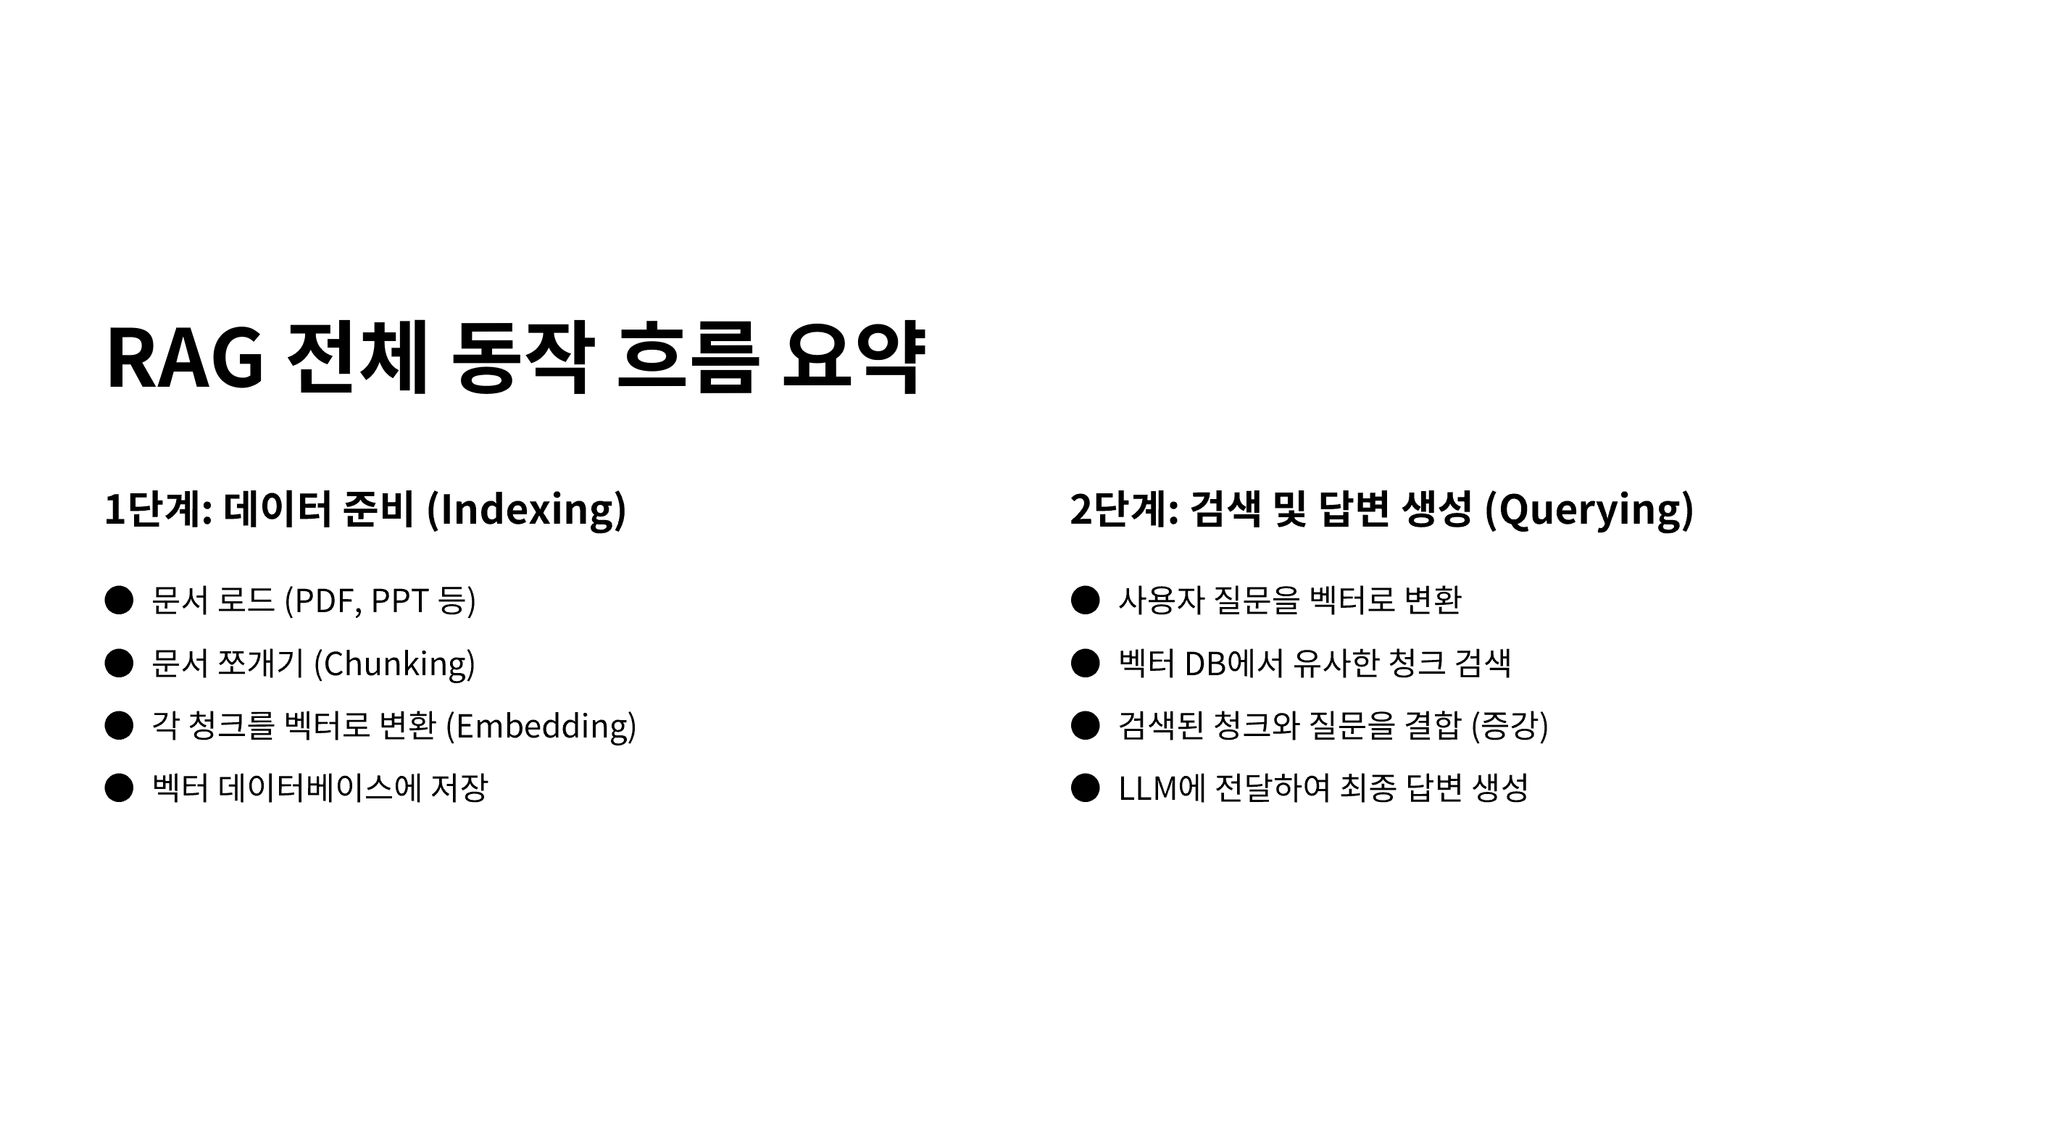
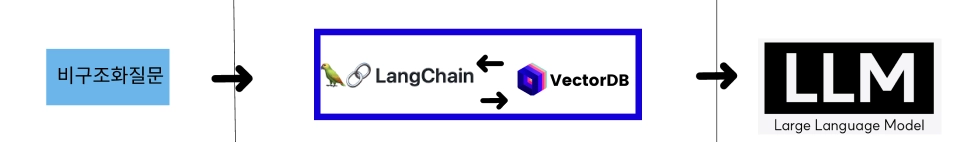
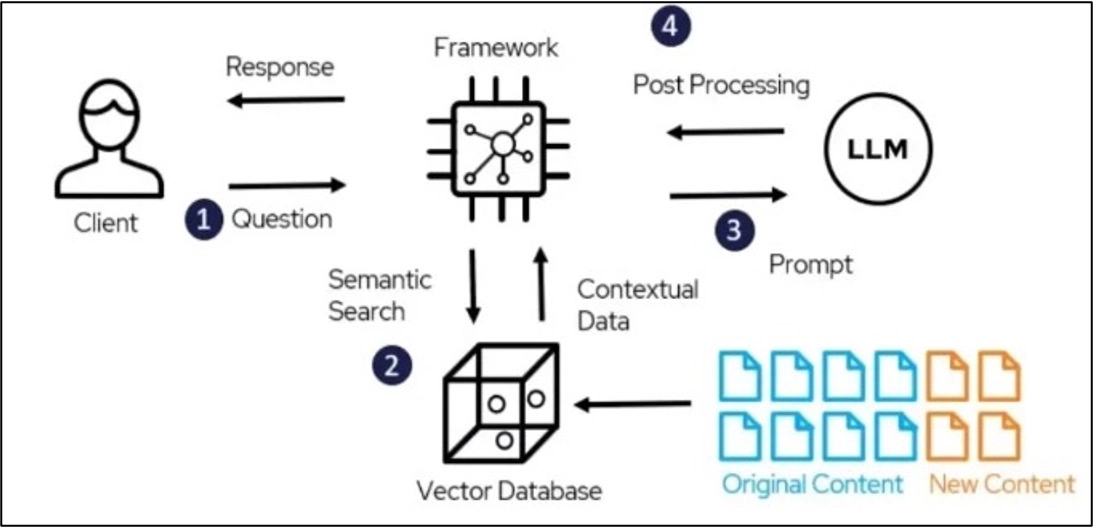
최종흐름 : 사내정책문서를 임베딩하여 벡터db에 저장 → 사용자의 질문 → 사용자 질의를 벡터DB의 문서 중에 검색 → 검색된 결과를 LLM에 넘겨 최종 응답 생성
•
RAG의 핵심요소 3가지
◦
vectorDB, LangChain, LLM가 RAG 아키텍처의 핵심요소
◦
vectorDB
▪
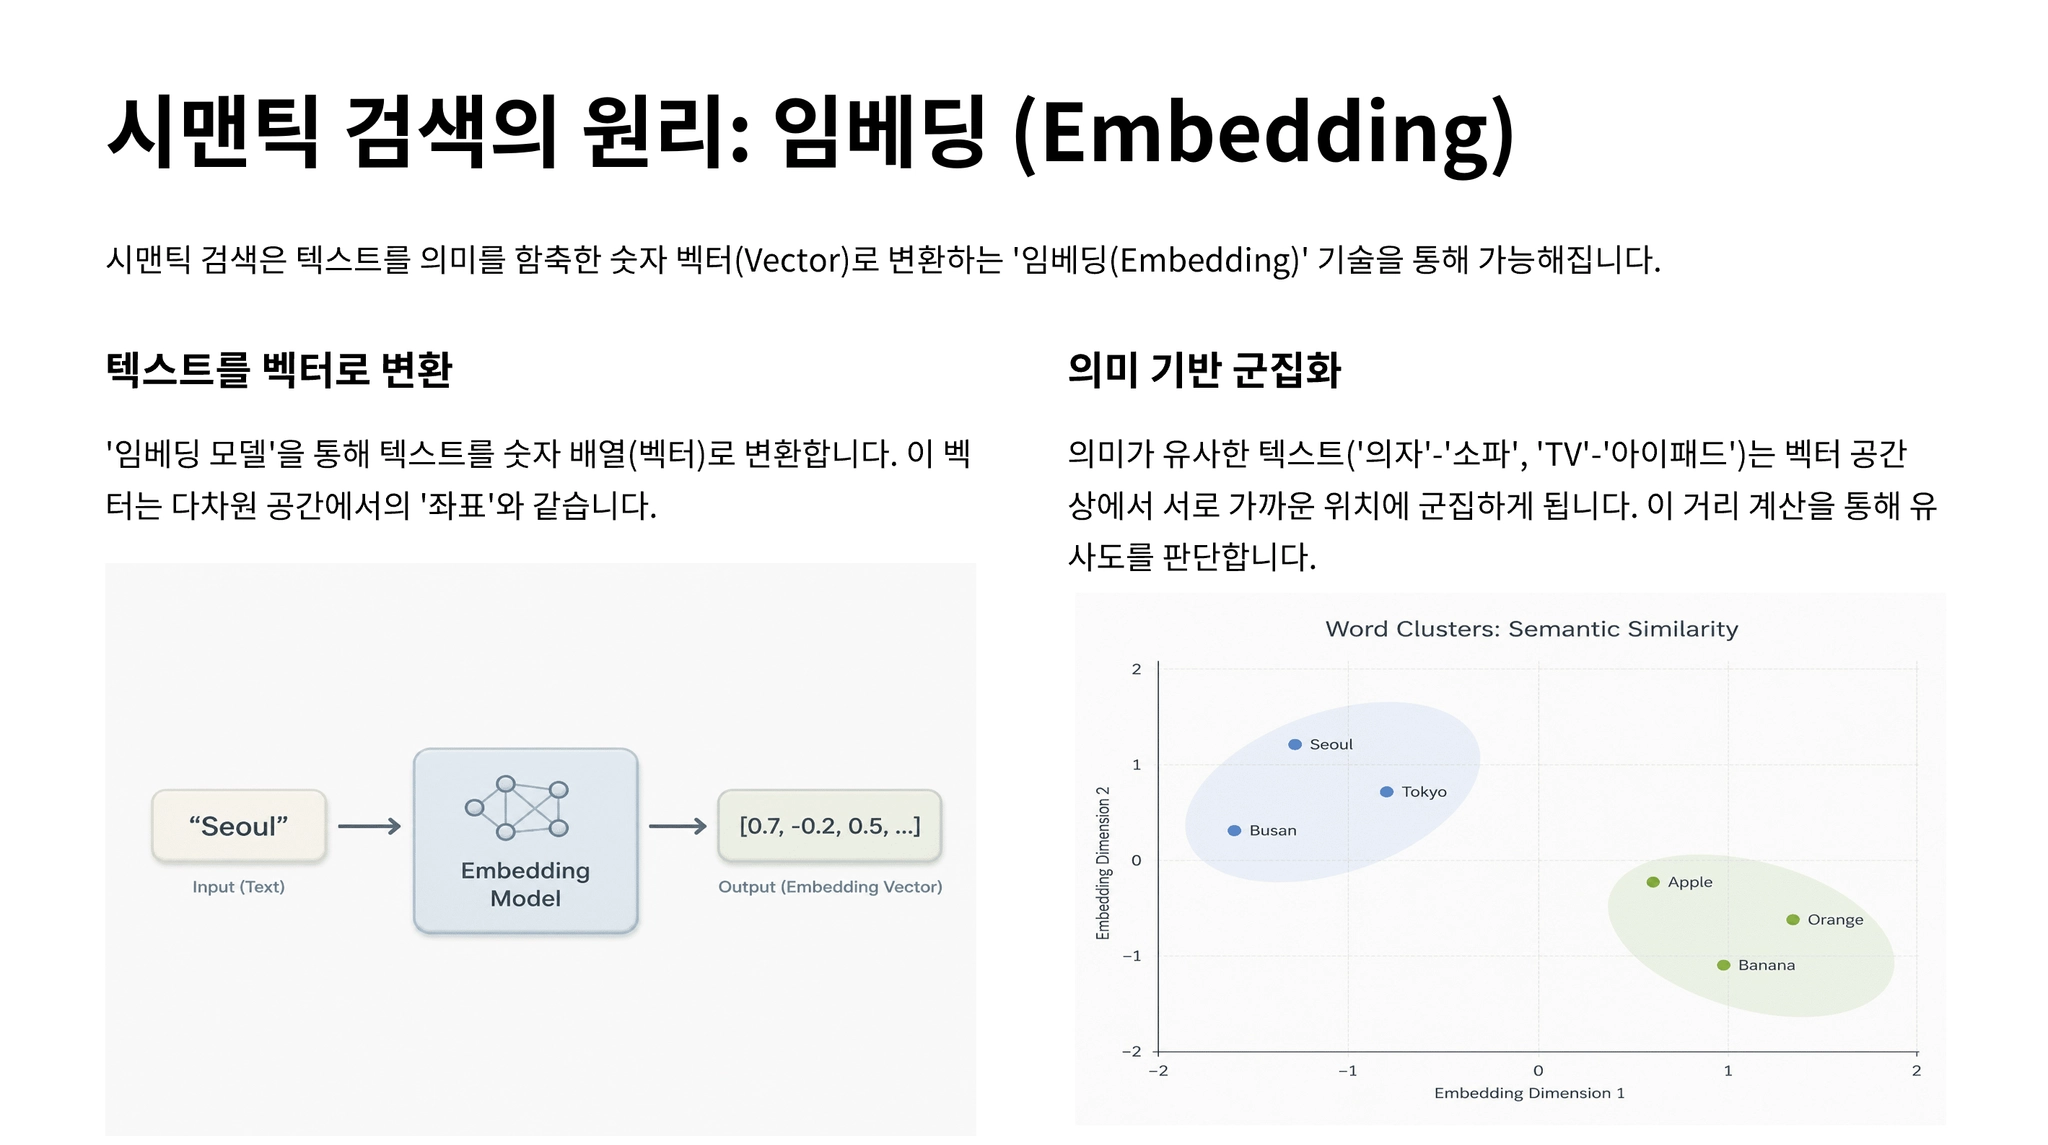
텍스트(단어/문장)을 컴퓨터가 다룰 수 있는 연속적인 숫자를 저장하는 공간
▪
우리 수업에서는 pgvector DB 활용 예정
◦
LangChain
▪
LLM 호출/응답, VectorDB에 저장/검색 등 일련의 작업을 쉽게 해주는 프레임워크
◦
LLM
▪
우리 수업에서는 openai 기반 분류/응답 처리 작업 수행
벡터와 코사인유사도
1) 벡터(Vector)란?
•
수학에서의 벡터
◦
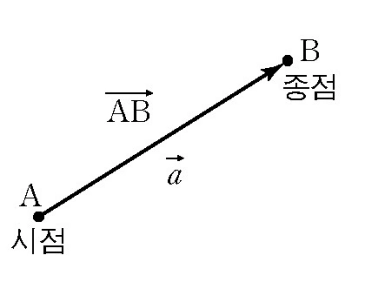
벡터는 크기(magnitude) 와 방향(direction) 을 가지는 수학적 대상
◦
n차원 공간상의 한 점(Point)을 벡터라고 지칭하기도함 ex)벡터B
•
AI에서의 벡터
◦
AI에서는 벡터를 “어떤 데이터의 의미/특징을 숫자 배열로 표현한 것” 으로 많이 사용
▪
예시) 사과(높이/너비)의 특성 배열 : [5, 20]
◦
일반적으로 텍스트, 이미지, 오디오 등의 데이터는 컴퓨터가 처리하기 어려으므로, 이러한 비정형 데이터를 임베딩(embedding) 과정을 통해 숫자 배열 형태의 벡터로 변환하여 사용
•
현실세계 데이터의 벡터화
◦
이미지
▪
픽셀의 밝기값들에 대한 데이터
▪
강아지 사진의 픽셀값 = [0.9, 0.3, 0.7, ...]
◦
텍스트(단어)의 특성에 따른 벡터화
▪
예시)집 데이터 (면적: 84, 방: 3, 거리: 500)
▪
3차원 벡터(배열)인 x = [84, 3, 500]로 표현
▪
사전에 특성을 정의하고 벡터화하는 방법은 현대적 AI 모델에서는 거의 사용하지 않음.
◦
단어의 현대적 벡터화
▪
현대적 AI에서는 미리 정의한 몇가지 특성이 아닌, 수많은 문맥속에서 귀납적으로 다른 단어들속에서의 관계와 특성을 학습하여 수치화
▪
예를 들어)
"파리는 프랑스의 수도이다"
"파리에 에펠탑이 있다"
"파리 패션위크가 열렸다"
"파리행 비행기를 탔다"
JavaScript
복사
•
위와 같은 수많은 문장을 귀납적으로 학습
•
이 과정에서 1)파리와 프랑스의 관계, 2)파리와 에펠탑의 관계, 3)파리와 패션의 관계, 4)파리와 여행의 관계 등을 다른 단어들과의 관계성 속에서 학습
•
파리 = [0.8, 0.9, 0.3, 0.7, 0.6, ...] 와 같은 수백차원의 벡터데이터로 변환
▪
즉, 다른 단어와의 관계성 까지 고려하여 n차원의 숫자로 변환(Embedding)
◦
문장의 벡터화
▪
단어의 벡터 뿐만 아니라, 문장끼리의 유사성을 기반한 벡터로도 확장
▪
문장 자체를 수치화 함으로서, 문장간의 유사성판별 등의 계산에 활용
▪
문장 벡터는 128/384/768/1536/3072 차원등이 사용
2)벡터의 내적(dot product)
•
수학적 정의
◦
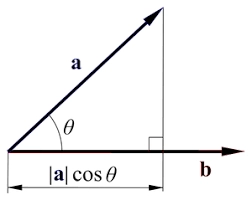
벡터의 내적은 두 벡터가 얼마나 같은 방향으로 향하고 있는지를 수치로 나타내는 연산
◦
두 벡터 의 내적
▪
두 벡터를 같은 좌표 자리끼리 행렬곱해서 더한 값
▪
예시)
•
a = [3, 4] , b = [2, 5] → 내적 = (3×2) + (4×5) = 26
•
a = [3, 4], b = [-4, 2] → 내적 = (3×-4) + (4×2) = -4
▪
내적값을 표준화하면, 최종적으로 내적이 1에 가까울수록 두 벡터가 유사하다는 것을 의미
•
직관적인 내적의 의미
◦
“내적값이 크다” = "두 벡터 사이의 각도가 작다" = "두 데이터의 특성과 내용이 비슷하다” = “(코사인)유사도가 크다(1에 가깝다)”
3) 벡터유사도의 활용
•
벡터유사도의 핵심 성질
◦
의미가 비슷한 데이터는 벡터 공간에서도 가깝게 만들어짐
◦
코사인 유사도(내적)를 사용하여 두 데이터가 얼마나 닮았는지 0에서 1 사이의 점수로 환산
•
대표 활용
◦
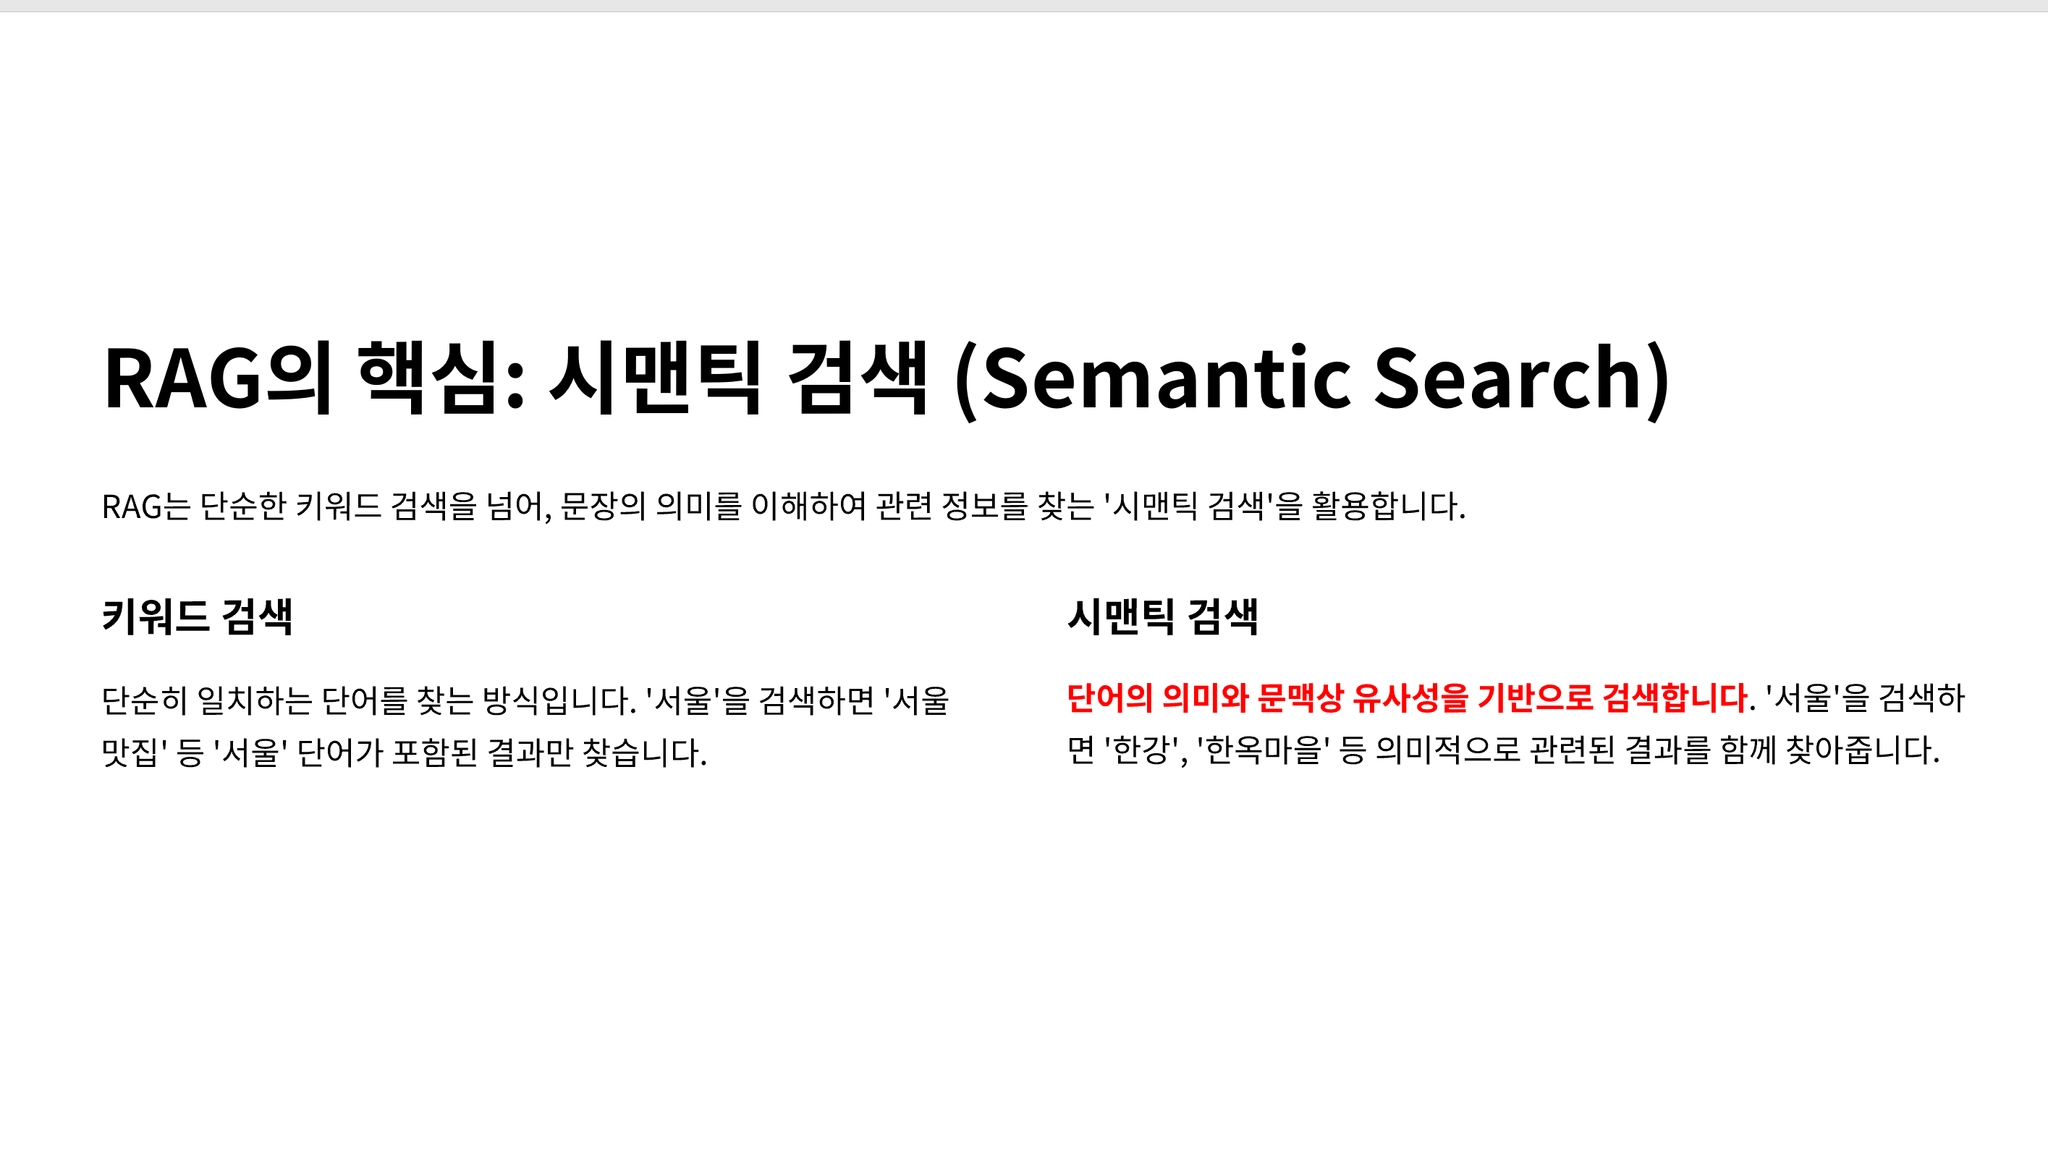
유사도 검색(의미론적 검색 - semantic 검색 )
▪
벡터 내적을 구하고 유사도를 계산하여 비슷한 문장들을 검색하는 것
▪
예를 들어)
•
DB에서 '강아지'로 검색하면 시 RDB는 '개'라는 단어가 포함된 문서 검색불가
•
유사도 기반 검색은 단어가 달라도 벡터값이 유사하고, 내적이 크다면 유사도 검색 가능
◦
RAG
▪
사전에 사내문서를 임베딩하여 벡터 DB에 미리 저장 → 사용자의 질문을 임베딩 → 벡터 DB에서 유사도가 높은 상위 k개(Top-k)를 추출→ 최종적으로 LLM에게 전달하여 답변을 생성
•
*임베딩 : 문장/문서/이미지 등을 고차원 벡터로 변환하는 작업
4) 임베딩과 벡터DB
임베딩
벡터 DB(Vector Database)